古法手搓文字的自留地

#16

使用AI Coding之后,对于事物的掌控力其实是在变弱的 关于AI Coding的思考(二)

最近在工作上遇到一些非常棘手的问题,让我想起了在没有AI之前解决问题的方式。在没有 AI 的时代,通常来说,我们对于一个功能的开发是渐进式的。虽然进度慢,但是我们对它的掌控力是比较强的,所以出现问题的时候也能够有的放矢。

AI时代来临之后,整个功能的开发节奏加快了很多,这必然就导致开发者对于具体代码的掌控力有所下降了。

我们用AI去开发一个demo,一个从0~1的独立的小项目,自然是能感受到其对传统古法编程的降维打击。但是对于一个大规模的线上运行的持续迭代的项目,其复杂程度就体现在更高的维度了。首先,AI无法获取充分的信息,比如说这个问题是偶现的;对于客户端来说,还有一些对AI更不利的问题:这个bug的表现通常是在UI上,对于一些纯逻辑的内容,AI可以通过日志or输出来精确地获得运行的反馈;但是客户端代码的反馈往往是可视化的,AI通常无法准确地理解。如果是偶现问题的话就更麻烦了,因为连开发者自己也没有办法获取全部的必要信息。

另外有一个问题,就是很多排查问题的潜移默化的经验在AI时代很容易丢失,特别是那些没有经历过古法编程时代的开发者。比如对于一个偶现的问题,我们要优先尝试复现,这里就涉及到这个问题是不是出现在特定的平台、特定的版本。对于我们的项目,除了特定的版本,还要找到对应的浏览器内核的版本。浏览器内核还要去加载小程序前端库的版本,一层套一层。这些事情在环境上都是隔离的,AI 无法帮你做到。至少目前是这样。

当然,AI 在一些比较独立、目标明确的事情上还是提效明显的。比如说,我可以通过日志直接去找到关键信息,还原出用户的行为链,再导入另一个工具进行回看,这是一个纯体力活,AI 干起来效率就挺高。

但我这个想法的核心意思是:在AI时代来临之后,人编码的吞吐量变大了,但对于代码的理解变得肤浅了。这样在复杂的系统里面出现问题之后,人的掌控力其实是下降了的。
#15

AI Coding时代的文档怎么写 关于AI Coding的思考(一)

在没有AI的时代,愿意自己写文档并且文档写得漂亮的程序员,会被认为是非常厉害的程序员。在AI时代来临之后,写文档的门槛变得很低了,也出现了不少流派。

比如有的流派认为应该先把文档写清楚,人来审核文档,AI来依据文档实现代码。这样有个问题,就是代码是在不断迭代的。有的小的改动,直接修改代码可能比从修改文档开始更容易。最终导致的结果就是文档和代码不一致。

如果先写代码,在每个代码文件的头部增加一些文档也是一种思路。但这也面临着同样的问题,AI不能百分之百保证代码更新了,文档一定能更新。

这里其实涉及到两个问题:一个问题是 single source of truth 原则,也就是说一个项目应该只有一个唯一的真相来源,这样可以避免歧义。另外一个问题是,代码的组织结构和文档的组织结构天然是不一样的,一个文档涉及的主题可能横穿多个代码文件。

我自己其实也没有什么好的解法,我现在用的方式其实是这样的。我不追求把一个项目建立完备的文档,我会把我对这个项目的开发经验沉淀成文档,特别是我负责的模块。对于每个项目,我有一个统一的模板。每个项目我会把它变成一个二级目录,然后在同级放一个docs目录。Docs 目录下面有三个一级目录,分别是 current、archive、working,代表三类不同状态的文档,Working 目录下面通常是按照当前的工作主题分的;current 是基于代码主线建立的,通常是按照模块来区分的。

我觉得比较有用的几个思想是:无论哪类文档,我觉得有几个文档是必须的,一个叫术语.md,因为我们有很多口头约定的命名,这些命名最好要和大致的代码位置对应起来,这样 AI 才不会理解出现偏差。比如说我们有一个业务叫拓展屏,它的本质其实是将浏览器的窗口内嵌在微信的数组窗口内部。如果直接对 AI 说“拓展屏”,它是很难理解其逻辑的。第二个文档叫Faq.md。因为代码的变动是非常频繁的,文档如果和代码一一映射,维护起来其实也很麻烦,相当于要维护两份代码。所以我觉得文档应该提纲挈领。对于每个模块,我觉得很多问题没必要把代码中已经清晰的内容放在文档里,还是在文档里面建立一个提问列表。

每次要开发这个模块的内容时,就通过 FAQ 去启动一个会话,让这个会话在一开始就能够了解 FAQ 的内容,建立一个比较可靠的上下文。

这是当前阶段的一些实践与思考,后面应该还会随着实践的增多有一些更系统的输出。

#14

之前也大大小小做了20多次分享,感觉在非AI时代分享这个事情还是比较因人而异的。以我自己为例,通常我对某一个主题进行分享的前提是,我已经有了一定的时间和理解,然后在短时间内做一个系统的梳理。分享的过程,也是我自己查漏补缺,审视自己的过程。但是没有什么章法可言。

AI时代下,我重新思考了一下这个过程。并设计了一个可以重复的SOP流程。

核心是将这个抽象的过程做成一个流水线,具体步骤如下:

  1. 构建想法与分享大纲(人工);
  2. 针对想法和大纲中的举例实证进行实际的调研;(AI辅助,人负责验收和判断)
  3. 生成文字描述版的分享笔记(类似于用于渲染的 DOM tree);(人工主导)
  4. 最终基于这个分享笔记,使用 slidev 等工具生成最终渲染的 PPT。(AI主导)

这个流水线不是单向的。调研可能修正原来的想法,写笔记可能暴露新的调研问题,试讲也可能推动内容和表达的调整。发生变化后,再让 AI 辅助更新受影响的环节。

我觉得最核心的原则是,把资料查找、验证中的执行工作,以及最终幻灯片的制作交给 AI;人把精力放在观点形成、证据判断和表达取舍上。

我不太认可丢出一个想法,让 AI 全盘接手并生成 PPT 的做法。因为我觉得 PPT 是讲者理解与判断的外显。如果跳过理解和审核,直接接受 AI 生成的整套 PPT,讲者就容易停留在复述页面内容,难以解释观点的依据,也难以回答追问。。

人可以委托很多执行工作,但要观点和其表达过程本身要由人把控。

#13

谈谈REA

最近有一个非常火的项目 :morluto/rea。因为自己平时也经常做一些逆向的工作,有的是工作需要,有的是个人需要。由于这个领域比较特殊,我之前都没有公开分享成果,但确实也是自己颇有心得的一个领域,所以想分享一下自己的感受。

首先是 rea 干了什么?

我对于 AI 在工程领域的各种爆火项目的感觉是:没有什么革命性的创新或“0 到 1”的工作,更多的是对工程经验的一种整合和萃取——将优秀的工程经验整合为标准化的 SOP 流程,提供给 AI Agent。

在没有 REA 之前,优秀的逆向工程师也是这么去分析的。但是 REA 做的是什么事情呢?它把各种技术产物(比如二进制的产物、Electron 的产物、安卓的产物等)的逆向流程做了标准化。有的产物的逆向流程有非常权威的工具,rea就直接复用了,有的没有标准化的工具,它就自己写了分析引擎。

这些东西在没有 REA 的时代,是需要大量学习才能掌握的和完成的。REA 把这些东西全都做成了标准化的流程,带来的结果就是:

  1. 对于会提问的普通开发者:做逆向的下限大大提高了。可能加固水平比较一般的软件,很容易就被普通人破解了。
  2. 对于懂逆向的人:他的上限也被大大提高了。因为很多机械性的工作 REA 都帮他先做好了,他可以在一个很高的起点上开始自己定制化的工作。另外AI的理解带宽比人大,人能够更加专注在自己的核心目标上了。

因为AI的到来,导致一些半开放性的经验的复用变成了可能(没有AI的时代,我把我的经验萃取出来,其他人也无法复用用,因为他没有这个背景知识,但是AI是有这些背景知识的,就让此类经验的沉淀有了意义:隐性知识第一次有了可执行的读者),软件工程领域来到了大蒸馏时代。

#12

做ToB类、办公类、效率类、工具类的软件,其本质就是要对抗某一个场景下的熵增(Systeom 2),因为趋于无序是自然的规律。 典型的:笔记、Todo、备忘录。

做toC类、生活、娱乐类的软件,通常不需要关心熵增,核心是爽就行了, 解决了当下的、具体的问题(System 1)就行了。

典型的:购物、音视频、游戏。购物记录、浏览记录、游戏对局记录,这些数据用户可能有一定的查看诉求,但是并没有很强烈的诉求需要将它们整理并持久化。

像PS / IDE / CAD这种工业软件,感觉兼而有之。

#11

国庆节前赶了一个产品demo的需求,时间紧,任务重,特别是中间遇到了几个 bug,花了不少时间才解决。

节后趁着脑子清空得差不多了,做了一下复盘,感觉最大的问题是:

  1. AI 对于一些模糊的描述也会进行错误的执行,而不是像正常人那样刨根问底,AI 经常自以为知道。
  2. AI 无法全面地评估自己的实现结果。至少在客户端这种 UI 需要通过编译运行并且会动态变化的场景,是很难完成从开发到验证的闭环的。

针对我的具体问题,比较特殊的是必须要掌握充分的背景信息,包括:Mac 的机制 、 Chromium 的机制、 我们项目的实现细节 。 加上这个项目有很多复杂的UI交互状态,一开始如果没有约定一套术语的话,会导致AI经常犯一些小错误。 这里有一个比较重要的经验是:要定义好术语,并将术语对应的代码位置做一个大致的绑定,这样能大大减少歧义。

另外,这个项目也有很多的背景知识,不能让 AI 每次新起一个对话去探索。这就涉及到外置的记忆,或者说这些文档如何去维护、如何去处理冲突、如何去防止腐烂、如何迭代进化。

AI维护的文档最核心的问题,是要保证人在时时刻刻也能够看懂并使用。一味地让AI去更新文档也没有用,最终只会膨胀到让人无法使用。

#10

最近在开发一个项目,我自己思考了一下,还是挺复杂的。具体复杂体现在几个层面:

1 UI就挺复杂的,要和各种的系统窗口打交道,并不是一个纯粹的Web UI 2 功能也挺复杂的,需要获取各种系统能力。另外还要去理解腾讯云、阿里云的各种语音SDK。 3 内部状态的维护也挺复杂的,语音输入各种交互状态之间的切换非常复杂,还要和UI保持一致 4 另外就是它本身是一个Agent的项目,导致调试起来也有很多不确定性

之前用Codex,因为上下文太短,导致经常触发上下文压缩。最近切换到了Claude Code, 这个问题好了很多。

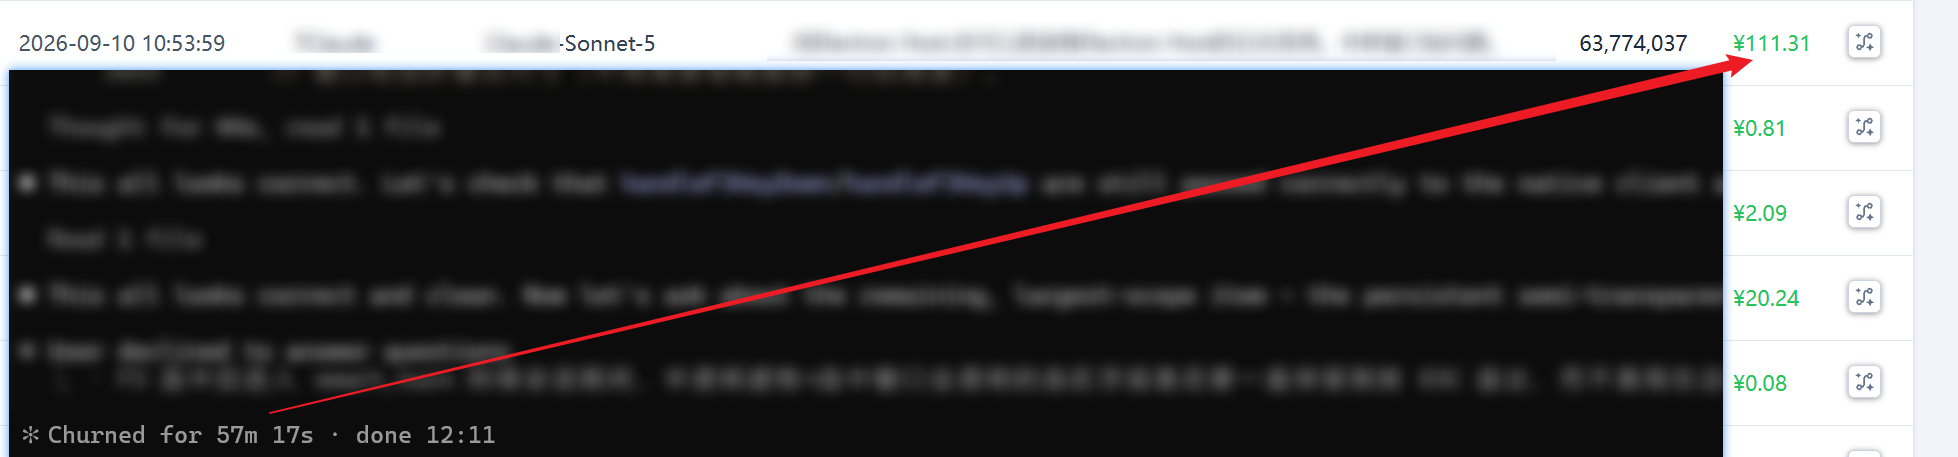
但是今天上午,我随便问了个问题,CC+Sonet-1m 给我查了快1个小时,我烧了100多块,我还是有点无法接受

因为我觉得我这些需求虽然复杂,但如果向AI表述清楚了,DeepSeek V4是完全能够胜任的。

最近AI Coding有点发毛了,感觉非常复杂的场景还是要人为的强力介入和引导

特别是当前这个项目,AI无法闭环完成验证,而且自身的各种交互和行为细节又非常的多。

#9

最近一直在 Codex 里面使用支持 response api 的 DeepSeek v4,但有一个问题是 Codex 默认写死了 300K 不到的上下文窗口,导致开发大型项目时需要频繁地压缩上下文,体验实在太差。

配置起来还有点麻烦,最近考虑引入其他工具了(Claude Code近期更新不少)~

#8

以后不会有产品和开发了,只有【发现&提出问题的人】和【解决问题的人】。

#7

学海无涯,何以为舟?

最近在研究 Chromium 的源码,由此产生一点感想:现实世界的工程其实都是非常庞大的。即使像 Chromium 这样一个非常高质量的项目,哪怕它的每一个模块、每一行代码都有学习的价值,我们也是很难去完全学习清楚的。

我觉得一个比较有效的方法是结合自己遇到的问题,再去深入地分析研究。总的来说,带着问题,带着目的,带着实践的反馈去研究一个模块,效果是最好的。

当然这里还要注意三个问题。

第一个问题是,很多东西是超越代码的。比如说,这个地方为什么要这么设计?它是为了什么样的场景、解决什么样的现实问题?这些东西不一定在代码里面有完整的体现。

第二个问题是时效性。你对一个模块今时今日研究懂了,但是这个模块是会不断更新迭代的,可能你以后不做这个方向了,你的知识又过期了。所以,更重要的是你要从这里面沉淀出一些更有价值的东西,补充到你的知识体系里面,而不是跟着这个项目走。

第三个问题是:研究透一个模块固然重要,但是实际上很多模块和问题都是交叉关联的。绝对不能把自己拘囿在一个具体的问题上,要时刻用联系的眼光去看待整个模块。即使我们没有精力去把其他的模块搞清楚,还是要有意识地去建立一张知识的网络图谱,而不是孤立、局部地看待问题。

当然,这里涉及到一个问题:我们选择自己工作方向的时候,一定要选择一个有足够上限,或者说生命力足够持久的领域,比如浏览器。我觉得像操作系统、安全还有编译器,这些可能都是比较底层,不可能被完全替代的领域。但是像安卓的一些框架或技术栈反而很容易被替代,所以选择方向也很重要:选择一个能做 20 年的方向,或者选择一个能够让自己投入毕生精力的方向。

最近我就在研究chromium的渲染管线和窗口抽象设计。首先,可以以这个为切入点来研究 Chromium 的某些模块。

其次,可以与之前自己对于 WebKit 和 Flutter 的一些研究关联起来,形成对比。